

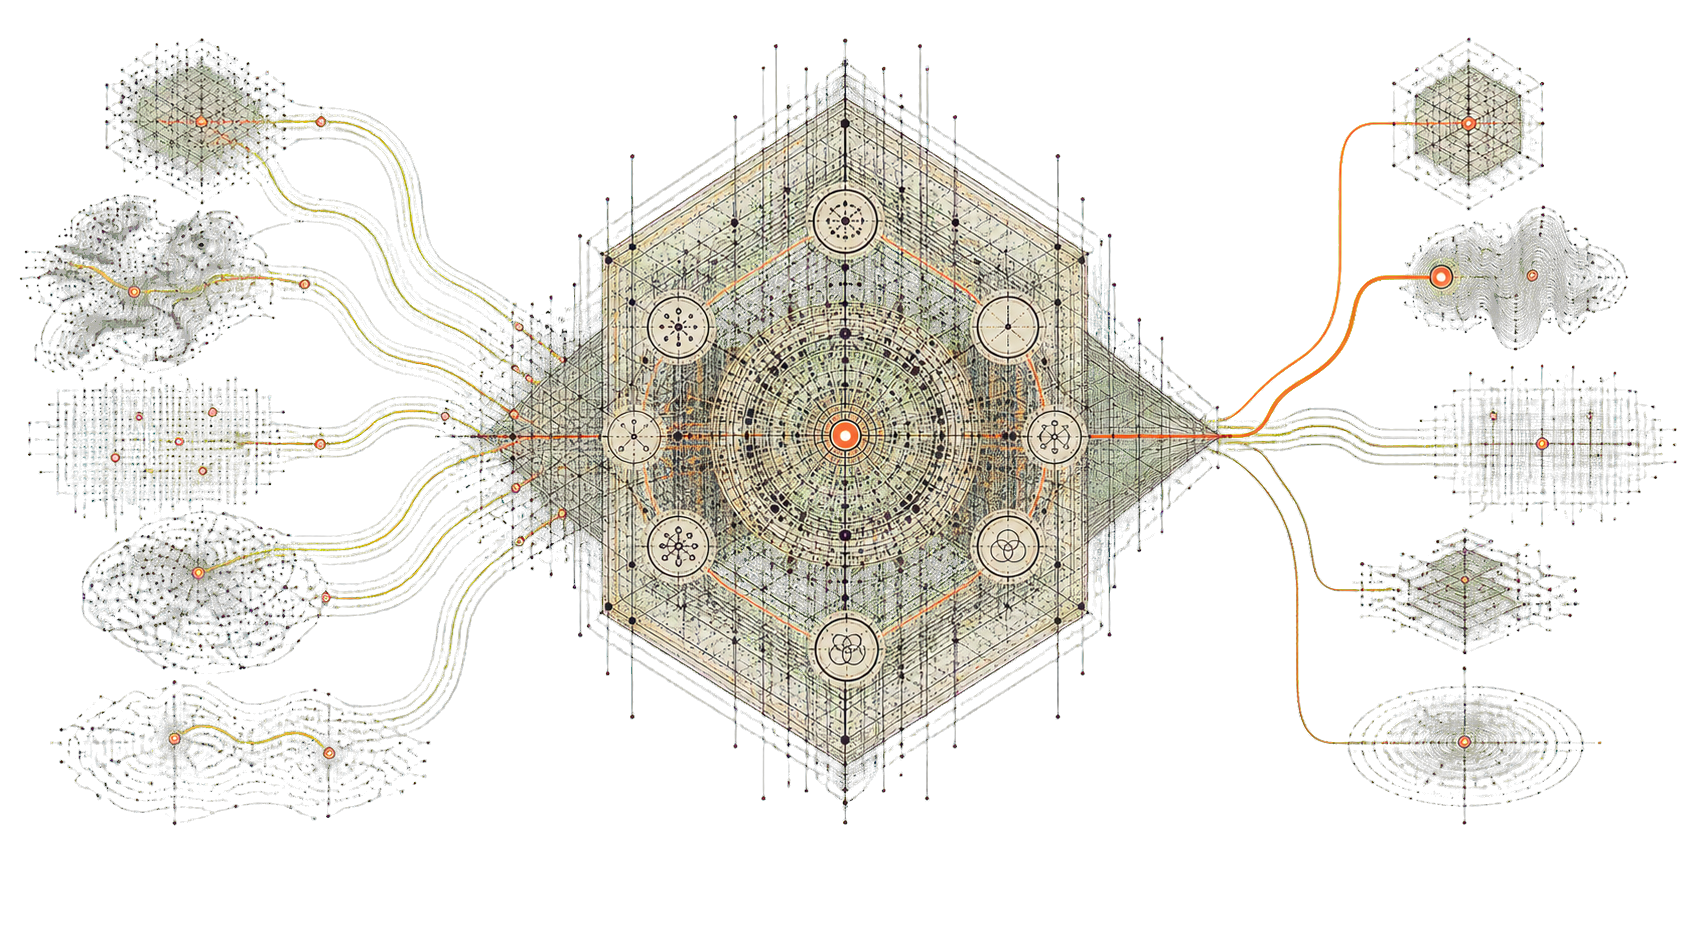
Em cada chamada
Buscar um grande volume, reenviar material e pedir que o modelo redescubra pessoas, relações, tempo, pendências e origem.
Quando identidade, tempo, relações e proveniência só existem dentro do prompt, cada nova tarefa precisa reconstruir a situação antes de começar a trabalhar sobre ela.
O Trailon cria uma camada contextual persistente entre as fontes da empresa e a inteligência que vai utilizá-las.
Uma resposta pode ser nova sem obrigar a empresa a reenviar e reinterpretar todo o universo factual que já havia sido organizado.
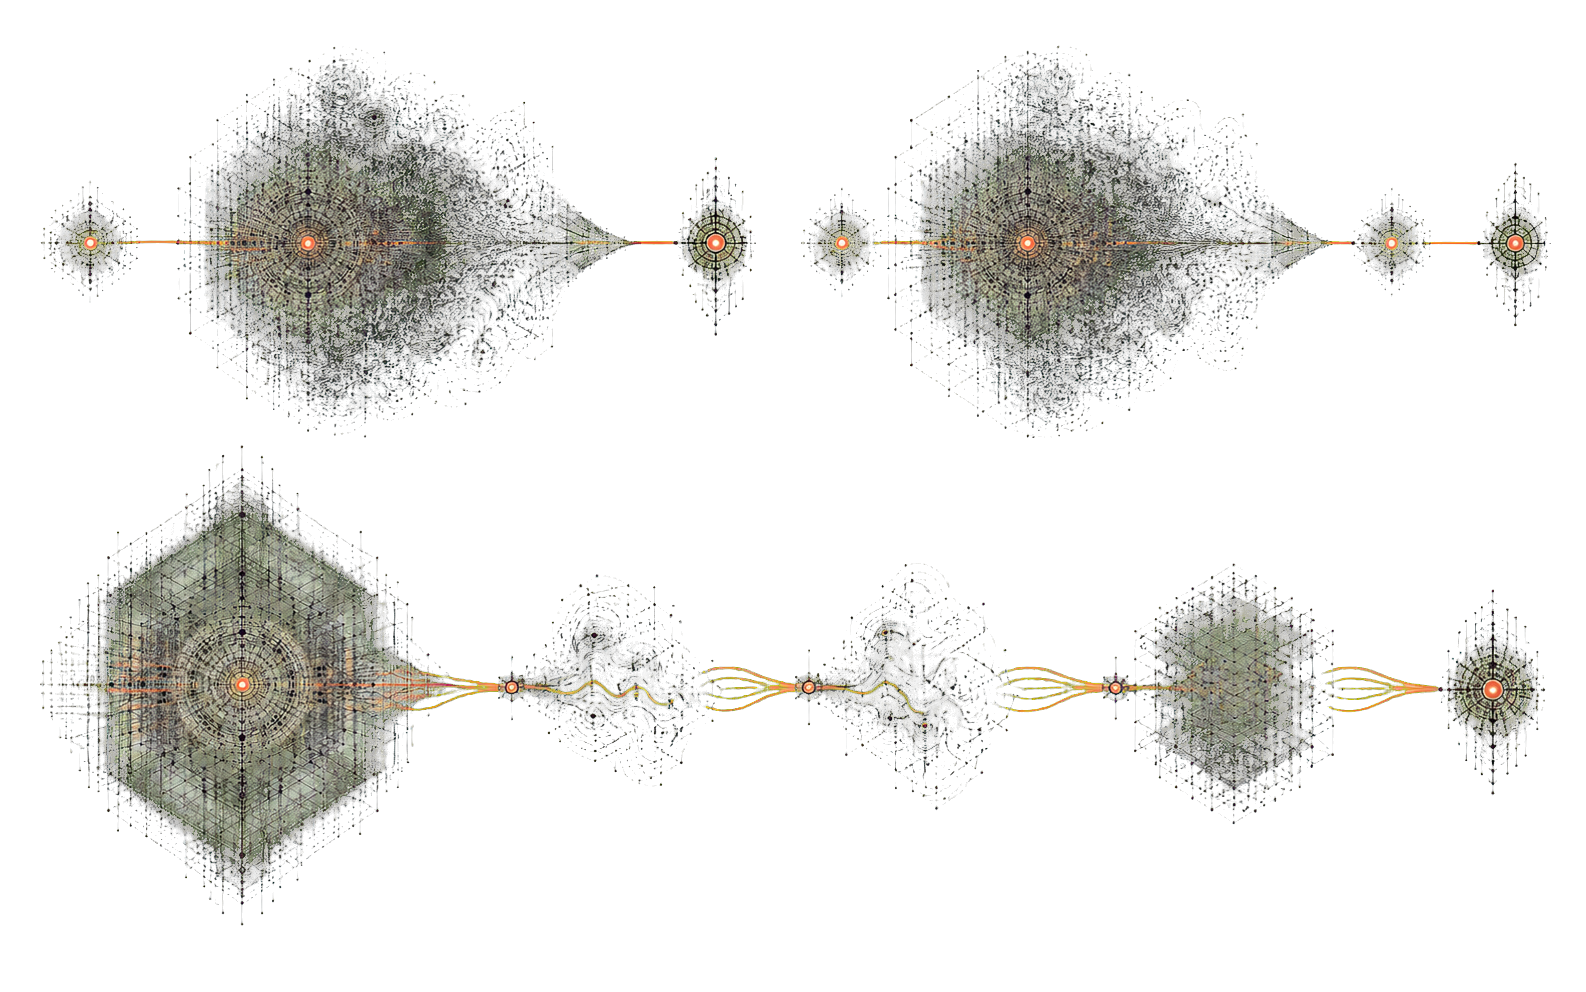
Buscar um grande volume, reenviar material e pedir que o modelo redescubra pessoas, relações, tempo, pendências e origem.
Recuperar a parte relevante da estrutura e usar geração onde linguagem, associação e raciocínio agregam valor.
Isso muda a responsabilidade da chamada generativa. O modelo deixa de ser o único lugar em que a situação ganha forma.
Quem é quem — e quais ambiguidades continuam abertas.
Quando algo aconteceu e quando passou a ser conhecido.
Que elementos permanecem ligados dentro da situação.
De onde veio e o que sustenta cada leitura.
O que mudou, foi revisado ou continua pendente.
A inteligência generativa interpreta o terreno. Ela não precisa inventá-lo novamente a cada pergunta.
Busca e RAG podem localizar material relevante. O Trailon acrescenta uma estrutura que continua existindo entre perguntas, aplicações e modelos.
No Trailon, fontes, atores, contextos, relações e tempo podem ser percorridos sobre a mesma situação. Modelos participam dessa experiência sem se tornarem a memória canônica dela.
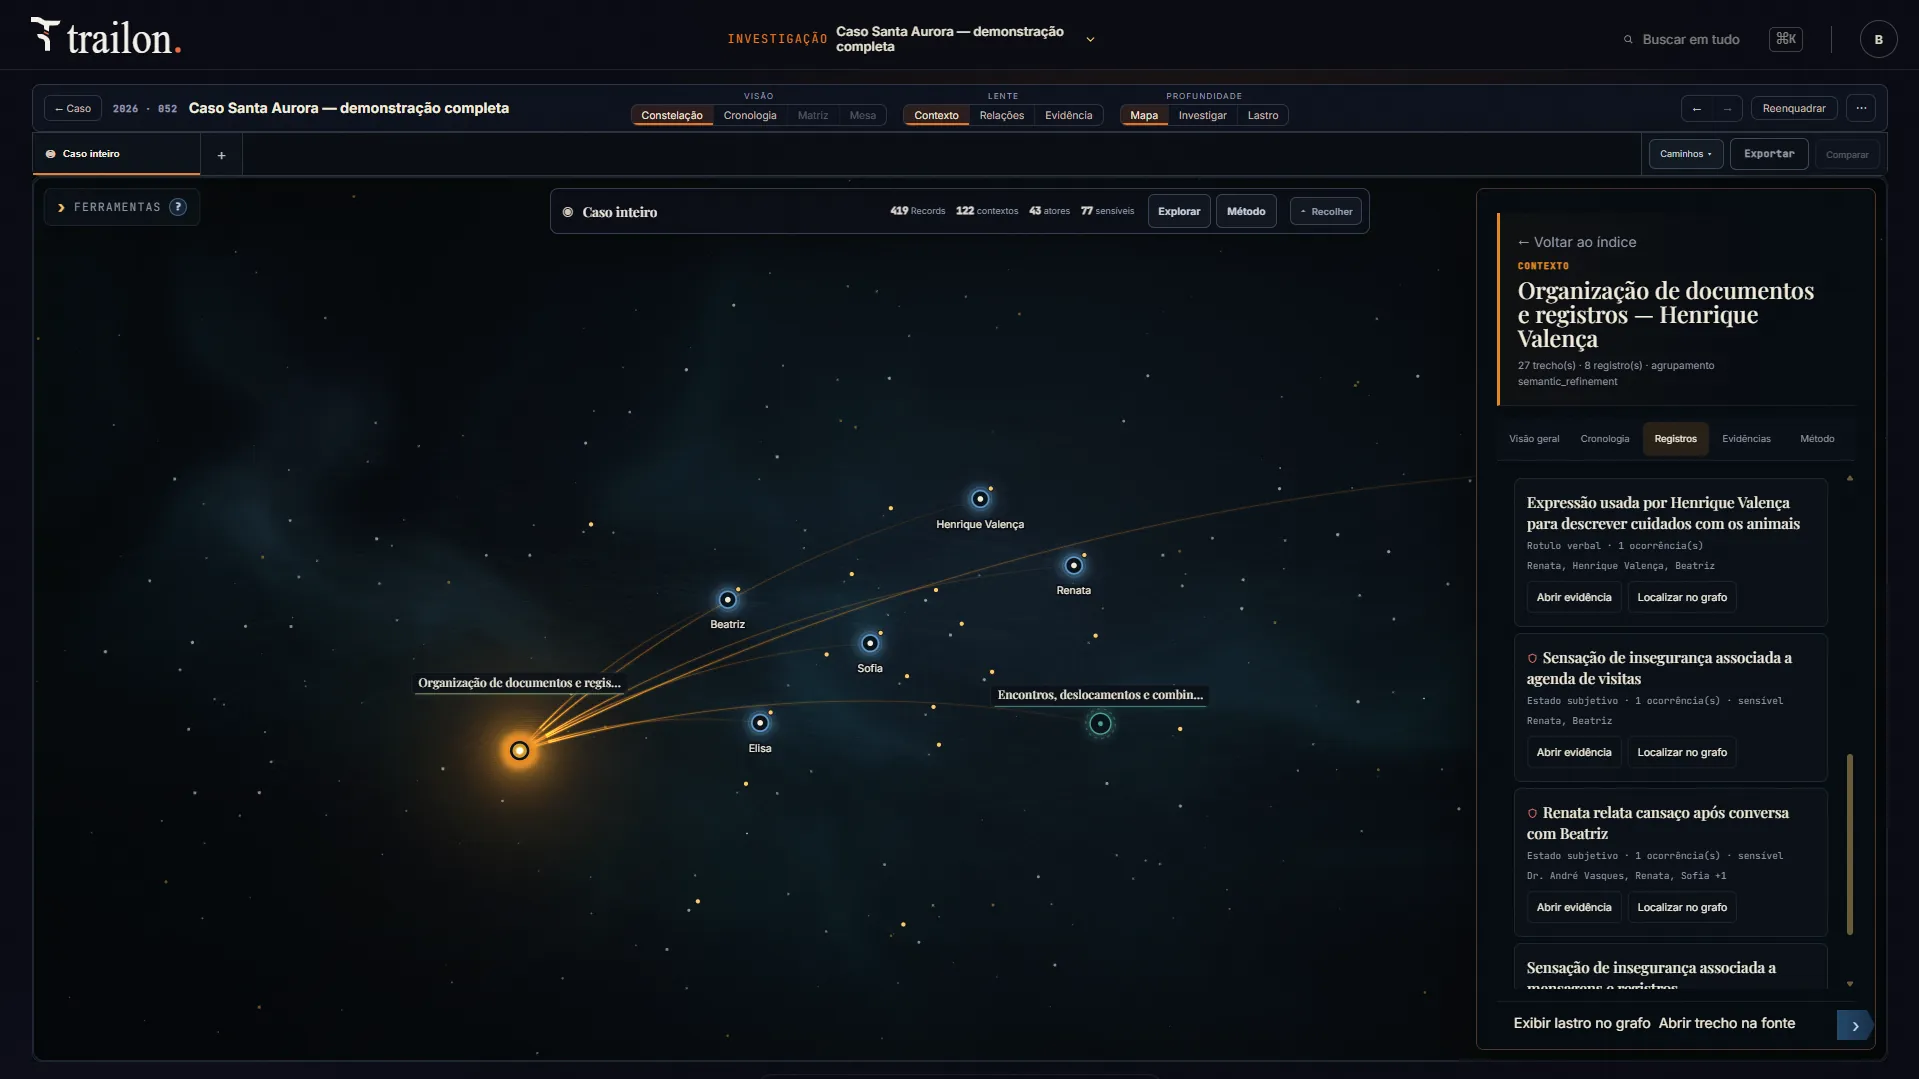
Providers, capacidades e políticas evoluem. A arquitetura separa a inteligência que interpreta da estrutura que sustenta a compreensão acumulada.
O Trailon não precisa substituir data lake, CRM, ECM, busca ou os modelos escolhidos pela empresa. Ele organiza e preserva o contexto que essas aplicações precisam utilizar.
A tarefa recebe o contexto que precisa, não uma tentativa de reconstruir tudo.
Estrutura já construída pode ser reutilizada entre perguntas e aplicações.
A situação não precisa desaparecer quando o provider ou o modelo muda.
Instruções orientam a tarefa sem carregar toda a memória factual.
Interpretações continuam ligadas ao material que permite examiná-las.
A empresa decide o que é estruturado, recuperado e enviado ao modelo.
Estruture contexto antes da geração e dê a cada modelo apenas aquilo que precisa interpretar naquele momento.